《深入解析Python反爬虫》任杰麟;苟如意【文字版_PDF电子书_下载】
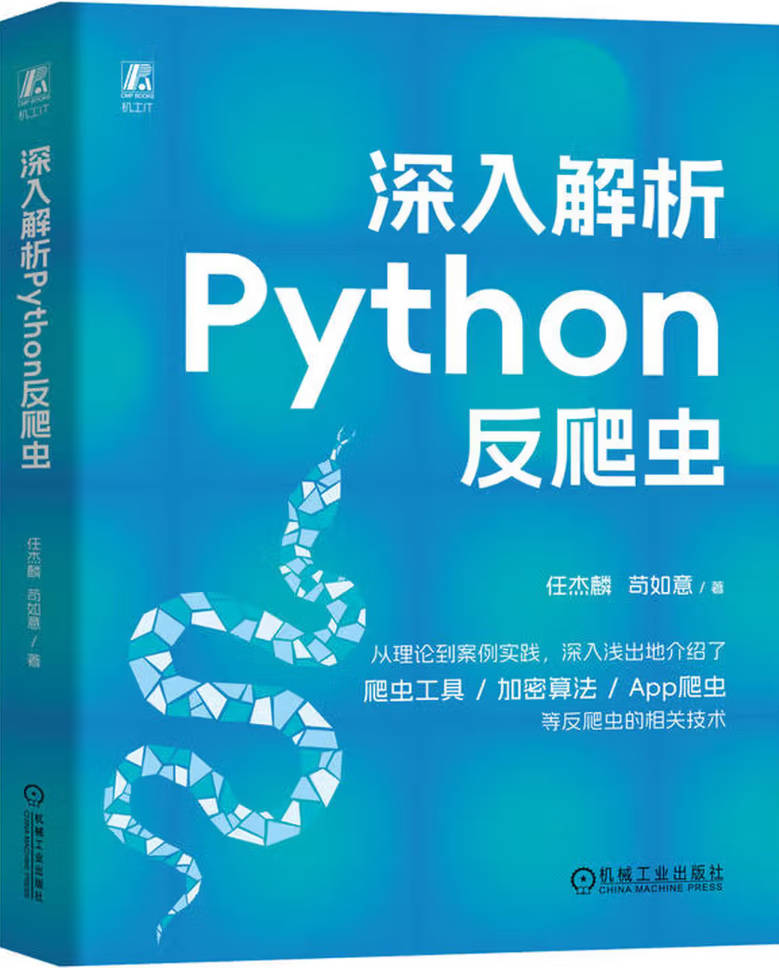
| 书名:深入解析Python反爬虫 作者:任杰麟/苟如意 出版社:机械工业出版社 译者:无 出版日期:2024-11 页数:/ ISBN:9787111764076 |
0.0 豆瓣短评 |
前往下载 |
当当正版 |
亚马逊购买 |
全网资源 |
内容简介:
本书主要介绍了反爬虫的相关技术,内容涵盖了爬虫工具、加密算法、App爬虫等,从理论到案例实践,深入浅出。本书详细讲解了常用的抓包工具、反爬虫机制、验证码识别、动态网页反爬虫、JavaScript文件处理。本书聚焦加密数据的破解、App应用爬虫以及破解方法、部署爬虫程序。对于以上内容,本书进行细分总结,将相关知识点都纳入其中,形成一套完整的体系。
本书适合Python爱好者、爬虫工程师、数据分析师,以及高等院校计算机科学技术、软件工程、网络工程等相关专业的师生。
作者简介:
任杰麟 硕士研究生学历,从事 Python、Java 方向的技术研发,拥有超过十五年的社交、金融、石油行业开发经验,始终战斗在编码第一线,平时喜欢钻研开源技术和数学。负责过石油领域数据分析的开发,以及人工智能的开发工作,长期担任数据爬取与数据分析的项目负责人,对网络爬虫和反爬虫有着较多的应用和感悟。
目 录:
第1章 无处不在的反爬虫/
1.1学习反爬虫的理由/
1.1.1反爬虫的定义/
1.1.2反爬虫对信息的保护/
1.1.3防止恶意竞争与知识产权侵犯/
1.1.4反爬虫对网站的维护/
1.1.5爬虫与反爬虫的相爱相杀:反爬虫对抗爬虫/
1.2什么样的爬虫会被反爬呢?/
1.2.1“裸体”爬虫/
1.2.2“索取无度”的爬虫/
1.2.3“不守规定”的爬虫/
1.3爬虫程序员的噩梦:多种多样的反爬虫机制/
1.3.1基于IP反爬虫:封锁IP/
1.3.2基于request headers反爬虫:检查“身份证”/
1.3.3基于用户行为的反爬虫/
1.3.4动态页面的反爬虫/
1.3.5登录限制(cookie限制)/
1.3.6验证码限制/
1.3.7JavaScript加密/
1.3.8文本混淆反爬虫:从根本上伪装信息/
1.4本章小结 /
第2章抓包利器的使用/
2.1抓包/
2.1.1什么是抓包?/
2.1.2抓包的意义/
2.1.3HTTP的抓包原理/
2.1.4HTTPS的抓包原理/
2.1.5常见抓包工具的对比/
2.2抓包工具Charles的使用/
2.2.1什么是Charles?/
2.2.2Charles的抓包原理/
2.2.3Charles的配置/
2.2.4使用Charles对网站进行抓包/
2.2.5使用Charles对App进行抓包/
2.3抓包工具Fiddler的使用/
2.3.1Fiddler简介/
2.3.2Fiddler与Charles的区别/
2.3.3Fiddler证书的安装/
2.3.4Fiddler的使用/
2.4抓包工具Mitmproxy的使用/
2.4.1Mitmproxy简介/
2.4.2Mitmproxy的工作原理/
2.4.3Mitmproxy的工作模式/
2.4.4Mitmproxy的使用/
2.5抓包工具Wireshark的使用/
2.5.1Wireshark简介/
2.5.2Wireshark与Fiddler的区别/
2.5.3Wireshark的使用/
2.6本章小结 /
第3章信息校验型反爬虫/
3.1信息校验反爬虫概述/
3.1.1信息校验反爬虫的原理/
3.1.2信息校验反爬虫的常见类型/
3.2useragent反爬虫/
3.2.1什么是UA?/
3.2.2UA的改变方法/
3.3cookie反爬虫/
3.3.1HTTP机制/
3.3.2cookie的作用/
3.3.3session和cookie的关系/
3.4Referer反爬虫/
3.4.1Referer的意义/
3.4.2Referer的破解方法/
3.5签名验证反爬虫/
3.5.1签名验证的原理/
3.5.2签名验证的破解/
3.6本章小结 /
第4章验证码识别/
4.1什么是验证码?/
4.1.1验证码原理/
4.1.2验证码的应用/
4.1.3验证码分类/
4.2图像识别技术/
4.2.1图像识别技术的基础知识/
4.2.2什么是OCR?/
4.2.3OCR原理/
4.2.4什么是Tesseract?/
4.3打码平台的使用/
4.3.1什么是打码平台?/
4.3.2如何使用打码平台/
4.4验证码爬虫案例/
4.4.1分析测试网站/
4.4.2实现模拟登录/
4.4.3核心代码/
4.5本章小结 /
第5章模拟登录/
5.1requests模拟登录/
5.1.1requests的基础操作/
5.1.2get请求方式/
5.1.3cookie的使用/
5.1.4post请求方式/
5.1.5get请求失败的案例/
5.2selenium模拟登录/
5.2.1什么是selenium?/
5.2.2安装selenium及驱动/
5.2.3网页结构与xpath简介/
5.2.4selenium的元素定位/
5.2.5使用selenium进行交互/
5.2.6使用selenium进行模拟登录/
5.3案例——selenium+验证码模拟登录/
5.3.1原理分析/
5.3.2获取验证码图片/
5.3.3实现selenium+验证码模拟登录/
5.3.4核心代码/
深入解析Python反爬虫5.4本章小结 /
第6章搭建IP代理池爬虫/
6.1IP的基础知识/
6.1.1IP地址的简述/
6.1.2什么是IPv4?/
6.1.3什么是IPv6?/
6.1.4IPv4与IPv6的对比/
6.2IP封锁/
6.2.1IP封锁反爬虫的基本原理/
6.2.2IP封锁的影响/
6.3如何突破IP封锁/
6.3.1降低爬虫性能——设置休眠时间/
6.3.2使用IP代理/
6.4IP代理/
6.4.1什么是IP代理?/
6.4.2为什么要进行IP代理?/
6.5IP代理池/
6.5.1实现IP代理/
6.5.2如何构建IP代理池/
6.6案例1——urllib的IP代理/
6.6.1代码简述/
6.6.2完整代码/
6.7案例2——构建IP代理池/
6.7.1代理网站分析/
6.7.2代理IP获取/
6.7.3代理IP检测与保存/
6.7.4完整代码/
6.8本章小结 /
第7章针对动态渲染页面的反爬/
7.1动态渲染网页的原理/
7.1.1静态页面和动态页面/
7.1.2JavaScript实现渲染的简单原理/
7.2动态渲染实现的方式/
7.2.1自动执行的异步请求/
7.2.2点击事件和计数/
7.2.3下拉加载和异步请求/
7.3解决动态渲染的反爬工具/
7.3.1selenium/
7.3.2puppeteer/
7.3.3Splash/
7.4案例——爬取漫画网漫画数据/
7.4.1动态渲染网页分析/
7.4.2实战——爬取漫画网的漫画数据/
7.5本章小结 /
第8章JavaScript解析/
8.1网页基础——前端三剑客/
8.1.1HTML——网站的骨骼/
8.1.2CSS——网站的皮肤/
8.1.3JavaScript——网站的行为/
8.1.4JavaScript的基础知识/
8.2开发者工具/
8.2.1开发者工具简介/
8.2.2模块介绍/
8.3如何找到JavaScript文件?/
8.3.1为什么要找JavaScript文件?/
8.3.2通过initiator定位JavaScript文件/
8.3.3通过search定位JavaScript文件/
8.3.4通过元素绑定的事件监听函数定位JavaScript文件/
8.4js2Py库/
8.4.1js2Py的作用/
8.4.2js2Py的使用/
8.5案例——翻译网站破解/
8.5.1案例目的/
8.5.2案例分析/
8.5.3案例实现/
8.6本章小结 /
第9章文本混淆反爬虫/
9.1图片伪装反爬虫/
9.1.1实现原理/
9.1.2图片伪装的案例/
9.1.3代码实现——破解图片伪装反爬虫/
9.2CSS偏移反爬虫/
9.2.1实现原理/
9.2.2CSS偏移反爬虫案例/
9.2.3代码实现——破解CSS偏移反爬虫/
9.3SVG映射反爬虫/
9.3.1什么是SVG映射/
9.3.2SVG图反爬原理/
9.3.3代码实现——破解SVG映射反爬虫/
9.4案例:爬取SVG相关网站/
9.5pytesseract的安装方法/
9.6本章小结 /
第10章逆向加密/
10.1MD5算法剖析/
10.1.1什么是MD5算法?/
10.1.2MD5的加密和解密过程/
10.2对称加密算法和非对称加密算法/
10.2.1对称加密算法/
10.2.2非对称加密算法/
10.3Base64伪加密/
10.3.1什么是Base64?/
10.3.2Base64加密与解密/
10.4HTTPS和证书/
10.4.1HTTPS的加密方式/
10.4.2证书的作用/
10.5本章小结 /
第11章App爬虫/
11.1Python爬取手机App的数据/
11.2什么是Appium?/
11.3如何安装Appium/
11.3.1安装JDK并配置其环境/
11.3.2配置Android开发环境,安装Android SDK/
11.3.3Node.js和Appium的安装/
11.3.4安装Appium Desktop和Appium inspector/
11.3.5安装Python驱动/
11.4Appium的使用/
11.5本章小结 /
第12章爬虫部署/
12.1了解Docker/
12.1.1什么是Docker?/
12.1.2使用Docker的优势/
12.1.3Windows与Linux的对比/
12.1.4在Windows系统上安装下载Docker/
12.1.5Docker的基本概念/
12.1.6Docker和虚拟机/
12.2Docker配置Python程序/
12.2.1Python程序/
12.2.2Dockerfile文件/
12.2.3配置Python程序/
12.2.4查看是否生成镜像/
12.2.5运行Python项目/
12.3Docker的基础使用/
12.3.1操作Docker/
12.3.2对镜像进行基础操作/
12.3.3拉取与删除镜像/
12.3.4加载镜像/
12.3.5使用交互式容器/
12.4本章小结